分组后再按条件过滤-Having子句
分组后再按条件过滤-Having子句
HAVING 子句作用
HAVING 子句需要与 GROUP BY 子句搭配使用,专门用于对分组聚合后的查询结果进行条件筛选,提取符合条件的分组数据。
核心区别:WHERE 子句是对分组前的原始数据表数据进行过滤,而 HAVING 子句是对分组后的聚合函数结果过滤。对分组结果做筛选时,禁止使用 WHERE 关键字,否则会直接报错。
完整基础语法
SELECT column1, column2
FROM table1, table2
WHERE [ conditions ]
GROUP BY column1, column2
HAVING [ conditions ];Code language: CSS (css)
实战场景讲解
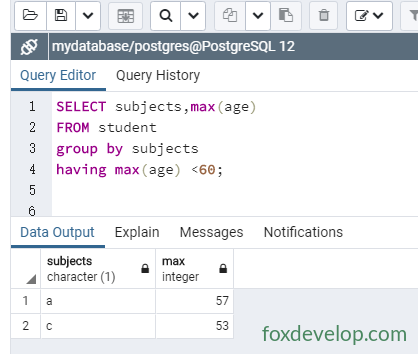
场景需求:根据科目分组,筛选出组内最大年龄不超过60岁的分组,也就是组内所有人员年龄均在60岁以下的科目分组。
执行逻辑:首先读取学生表全部数据,再根据科目字段分组并统计每组最大年龄,最后通过 HAVING 对分组后的最大年龄数据进行条件过滤。
示例语句一
SELECT subjects,max(age)
FROM student
GROUP BY subjects
HAVING max(age) < 60;
示例语句二
多字段统计筛选,统计各科目分组的数据总数、最大年龄、最小ID,并筛选出分组最大年龄小于70岁的分组:
SELECT subjects,count(1),max(age),min(id)
FROM public.student
GROUP BY subjects
HAVING max(age)<70;Code language: CSS (css)
核心总结
只要是对分组聚合之后的结果进行条件过滤,只能使用 HAVING 子句,绝对不能使用 WHERE 子句。
Previous: 分组GROUP BY
Next: 条件查询