一、 什么是 Beautiful Soup
- 核心定位:一个用于从 HTML 或 XML 文件中提取数据的 Python 库(文档插画源自《爱丽丝梦游仙境记》)。
- 主要功能:提供简单、Python 式的函数,用于文档的导航、查找、修改分析树及修改文档内容。它通过解析文档,为用户提供需要抓取的数据,代码量少即可写出完整的抓取应用程序。
- 编码处理:自动将输入文档转换为 Unicode 编码,输出文档转换为 UTF-8 编码。若文档未指定编码导致无法自动识别,仅需手动说明原始编码即可。
- 解析器支持:本身是一个“解析器适配层”,可搭配
lxml、html5lib及 Python 标准库解析器等出色的底层解释器,提供不同的解析策略与速度选择(推荐生产环境使用lxml,容错好且速度快)。
二、 PyCharm 中安装 Beautiful Soup
- 准备文件:在 PyCharm 项目中新建一个测试文件(如
bs4demo.py)。 - 打开设置:点击菜单栏
File->Settings(macOS 为Preferences) ->Project: 项目名->Python Interpreter(项目解释器)。 - 选择解释器:确保选中当前项目对应的 Python 解释器(尤其是虚拟环境 venv)。
- 搜索安装:点击包列表右侧的
+ 号按钮,搜索框输入bs4(或完整包名beautifulsoup4),选中后点击左下角的 Install Package(安装按钮)即可(建议勾选指定版本选项以获取稳定版)。 - 验证安装:在
bs4demo.py中输入from bs4 import BeautifulSoup,无报错即代表安装成功。
三、 补充:命令行安装与注意事项
- 安装命令(PyCharm 底部 Terminal 或系统终端):
pip install beautifulsoup4
(若下载超时,可加超时参数:pip --default-timeout=600 install beautifulsoup4) - 名称区别:安装包名为
beautifulsoup4,导入模块名为bs4。切勿混淆导致ModuleNotFoundError报错。 - 建议配套安装解析器:
pip install lxml
使用时显式指定解析器以保证跨环境一致性:soup = BeautifulSoup(html, 'lxml')。
四、 极简入门代码示例
from bs4 import BeautifulSoup

html_doc = """
<html><head><title>测试页</title></head>
<body><p class="title"><b>测试标题</b></p>
<a href="http://example.com/1">链接1</a>
<a href="http://example.com/2">链接2</a>
</body></html>
"""

# 解析文档(指定 lxml 解析器)
soup = BeautifulSoup(html_doc, 'lxml')

# 提取标题与所有链接
print(soup.title.string)
for link in soup.find_all('a'):
    print(link.get('href'), link.text)Code language: HTML, XML (xml)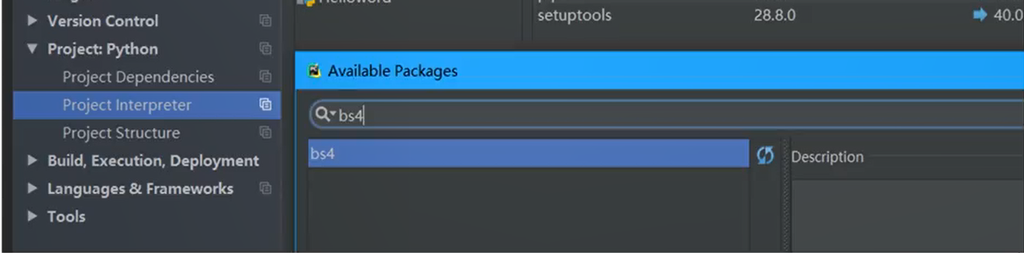
Next: BS4的快速使用